面對 AI Agent 成為企業資料的新使用者,Plasma 從既有資料環境出發,整合異質資料、Data Product 與 AI 存取能力,降低企業導入 AI 所面臨的資料工程門檻。
隨著生成式 AI 從聊天與內容生成,逐步進入企業流程、自動化與 AI Agent 應用,企業資訊架構所面臨的挑戰,也開始從模型與算力進一步延伸到資料。寬橋(Brobridge)持續深化解決方案 Plasma - AI Ready Data Platform,協助企業在不大幅改造既有資訊系統的前提下,整理、整合並提供企業資料,為 AI 與 Agent 建立可持續發展的資料基礎。
在日前舉行的 iThome KubeSummit 2026 中,大會以「從 Cloud Native 到 AI Native」為核心議題。從 AI 工作負載、GPU 資源治理到 AI Agent,企業開始面對一項更根本的問題:當 AI 不再只是獨立工具,而是逐漸參與企業營運流程,它要如何正確找到、理解並使用散落在不同資訊系統中的企業資料?
對多數大型企業而言,真正具有價值的資料往往分散於 Oracle、MySQL、PostgreSQL、SQL Server、企業資料倉儲、Data Lake,以及 ERP、CRM、MES、Legacy System 等不同世代的系統之中。這些系統並不是為生成式 AI 所設計,但其中卻保存著企業最重要的客戶、交易、營運與生產資訊。
因此,企業導入 AI 所面對的問題,已不只是「如何把資料送給模型」,而是如何在既有 IT 架構之上,建立一套能長期供應 AI 應用的資料能力。
不為 AI 重建一套資料世界
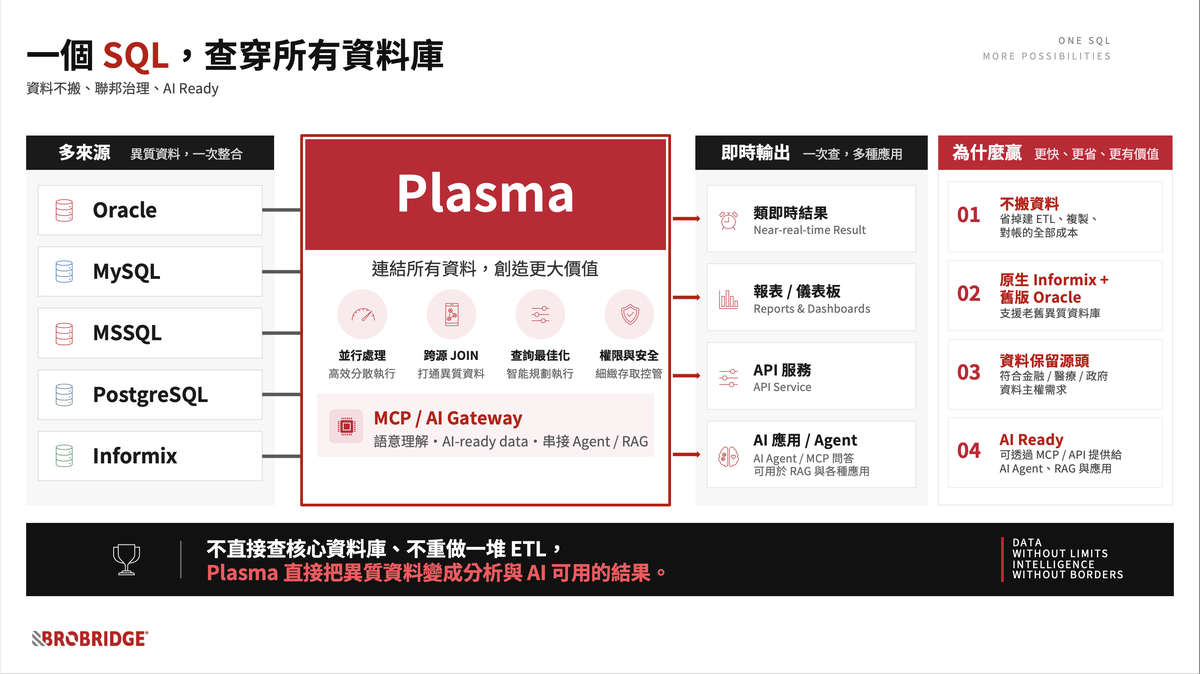
不同於要求企業先將所有資料集中搬移到新的 AI Data Store,Plasma 的設計方向,是從企業既有的資料環境出發,在盡量不改變傳統資料管理者的習慣及不增加額外負擔下,於不同資料來源之上建立統一的資料存取、整理、管理與供應能力。
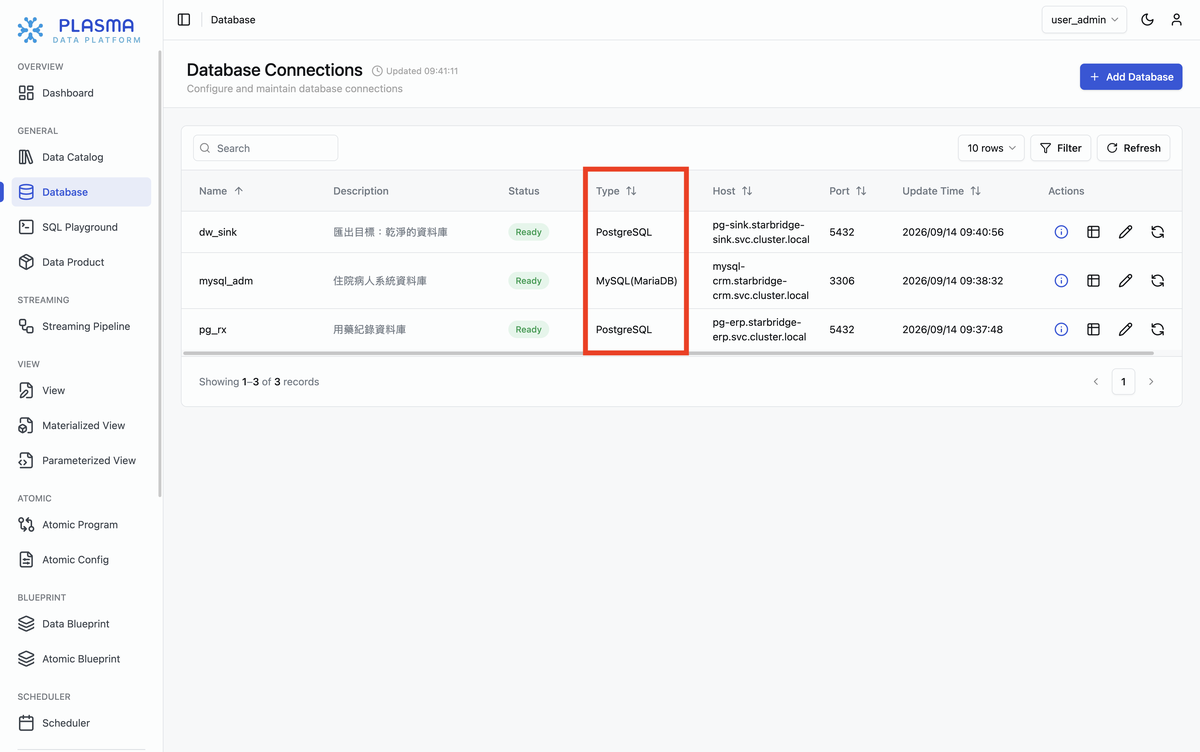
透過 Plasma,企業可依需求串接既有資料來源,建立跨來源資料存取能力,並進一步運用 View、Materialized View、排程、Data Product、Data Catalog,以及視覺化管線資料流程等機制,將底層分散且異質的資料,逐步轉化為可被應用程式、分析服務及 AI 使用的標準化資料能力。在 Plasma 提供的最新解決方案下,內建的 Ontology 知識庫萃取技術,更可以主動理解和分析既有的資料庫和 IT 系統,並作為企業內應用知識專家來支援各類 AI Agent 的作業,彌補 AI 到 Legacy 資料系統之間的落差。
這樣的架構讓企業無須因為導入新的 AI Use Case,就反覆建立新的資料副本、ETL Pipeline 或獨立的 AI Data Store,也降低因新技術導入而產生另一座資料孤島的風險。寬橋表示,企業多年累積的資料基礎建設不可能因為生成式 AI 出現就全面淘汰。真正可行的 AI 轉型,應該是在保留既有 IT 投資的前提下,讓原本服務應用程式與人員的資料能力,進一步成為 AI 可以安全使用的企業能力。
從資料整合進一步走向 AI Ready
過去資料平台主要面對的是工程師、分析人員、BI 系統以及企業應用程式,而進入 Agentic AI 時代後,AI Agent 正逐漸成為新的資料消費者,這也使企業資料平台面臨新的要求。
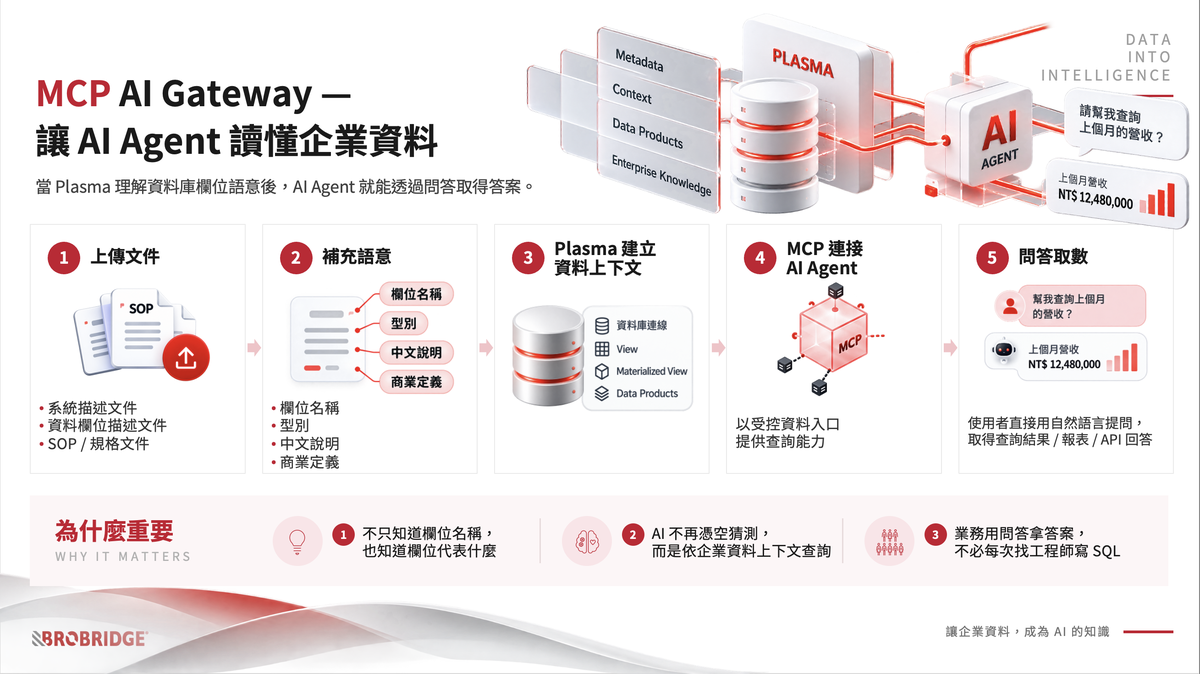
AI 即使知道如何產生 SQL,也不代表它知道哪一張資料表才是正式資料來源;能辨識「Revenue」這個欄位,也不代表它理解企業內部對實際營收的定義。除了存取資料之外,AI 還需要進一步理解資料來源、關係、業務語意、權限與使用方式。
因此,Plasma 的發展方向並不只停留在傳統資料整合,而是逐步將企業資料整理為 AI 可以發現、存取及使用的 Data Product,並建立上層 AI 與 Agent 所需要的資料服務介面。
從底層的異質資料來源、資料整合與流程,到 View、Materialized View、Data Catalog 與 Data Product,Plasma 希望建立企業既有 Data Estate 與未來 AI Agent 之間的中介層,使上層 AI 應用不必直接理解每一套資料庫與 Legacy System 的技術細節。
從 Cloud Native 延伸至企業資料基礎
寬橋長期投入 Kubernetes、Cloud Native 與企業資料技術,也是 CNCF 認可的 Kubernetes Certified Service Provider(KCSP)。從早期協助企業導入 Kubernetes 與微服務,到異質資料同步、Data Mesh、Near Real-Time ETL,再到目前的 AI Ready Data Platform,產品技術發展逐步從運算基礎設施延伸至資料基礎設施。
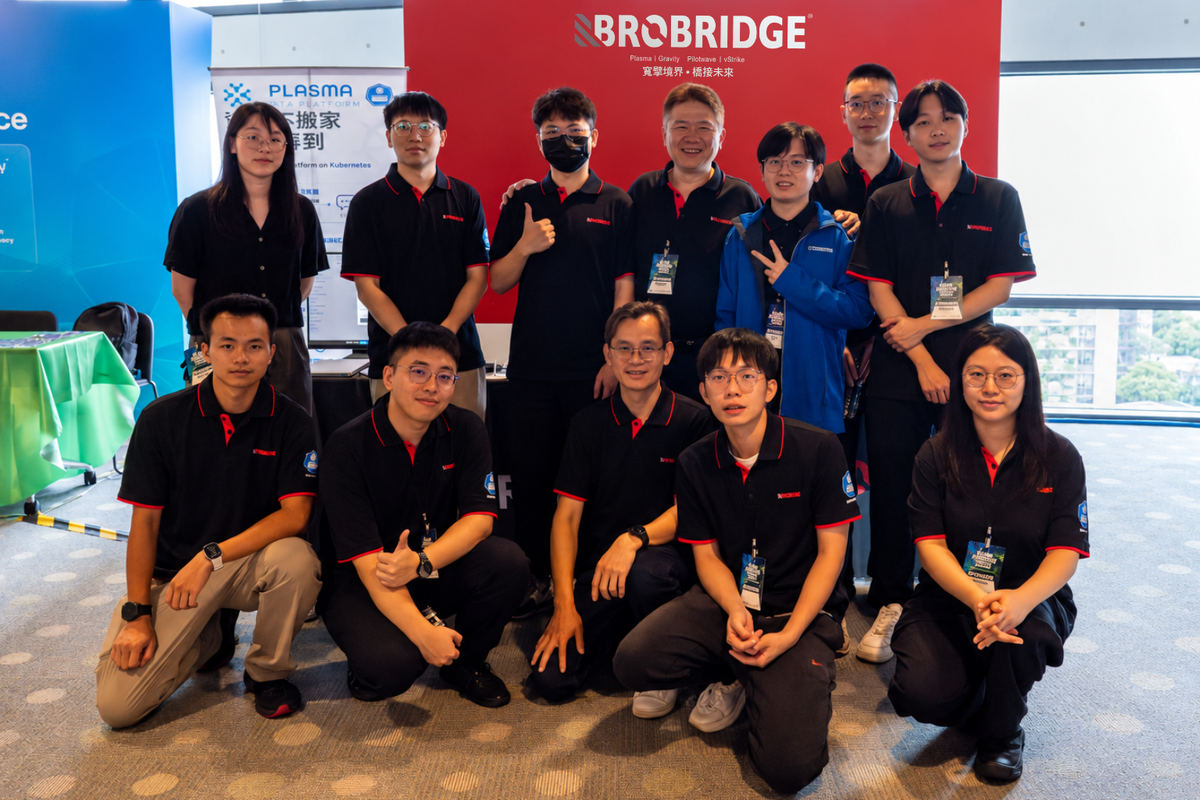
在 KubeSummit 2026 中,寬橋也分別從 Infrastructure、Security 與 Data 三個面向呈現 AI Native 企業架構,包括自動化私有雲基礎設施、Kubernetes Workload 零信任防護,以及以 Plasma 建立 AI Ready 資料平台。
寬橋認為,Cloud Native 過去十年所完成的重要工作之一,是將 Server、Storage 與 Network 等底層資源逐步抽象為平台能力;而進入 Agentic AI 時代後,企業接下來需要處理的,將是如何把資料庫、Data Lake、API 與既有企業系統中的資料,進一步轉化為 AI 可以安全且可靠使用的企業能力。
為 Agent Ready 的下一階段做準備
隨著 AI Agent 從概念驗證逐步進入企業正式環境,資料平台未來需要處理的也將不只是直白的資料存取而已,企業資料系統有關的各類 Metadata、Semantic、Lineage、Identity、Permission、Data Contract,以及存在於企業流程與程式邏輯中的 Business Logic,都將逐漸成為 AI 理解企業資料的重要 Context。
Plasma 未來將持續沿著 AI Ready Data Platform 的方向發展,讓企業能從既有資料整合與 Data Engineering 基礎逐步向上延伸,在不推翻原有資訊架構的情況下,為 AI 與 Agent 建立更完整的企業資料環境。寬橋表示,企業 AI 的下一階段,不只是選擇哪一個模型,而是能否讓 AI 真正使用企業多年累積的資料與知識。讓既有資料成為 AI 可以可靠使用的企業能力,將是 Plasma 接下來持續投入的核心方向。
關於 Plasma
Plasma 是寬橋推出的 AI Ready Data Platform,面向企業異質資料環境,提供跨資料來源存取、View、Materialized View、排程、Data Product、Data Catalog 以及視覺化管線資料流程等功能,在不大幅改變傳統資料庫架構和操作習慣下,協助企業整合既有資料資產和系統,建立從資料工程、資料供應到 AI 應用所需要的統一資料基礎和查詢介面。
除了傳統的資料工程所需工具,寬橋研發了自家獨步的 Ontology 知識庫專家技術,可用於學習理解企業內部的資料關係和應用系統之間的關聯,能成為 AI Agent 於企業內部可協作的資料專家和系統專家,在最低的負載與算力為前提需求下,能更準確、有效率的應用企業內部來自不同應用系統的資料。
關於寬橋 Brobridge
寬橋長期投入 Cloud Native、Kubernetes 與企業資料技術,提供企業級雲原生基礎架構、資料平台與相關技術服務。寬橋亦為 CNCF 認可的 Kubernetes Certified Service Provider(KCSP),持續協助企業從 Cloud Native 基礎架構向資料與 AI Native 應用發展。